جامعة طيبة تختتم مؤتمر MCAIT 2026 بنتائج بحثية في الذكاء الاصطناعي ودقة تصل إلى 98.29%
المدينة المنورة – 6 نوفمبر 2026م
اختتمت جامعة طيبة بالمدينة المنورة أعمال المؤتمر الدولي السادس للذكاء الاصطناعي وتقنياته (MCAIT 2026)، بعد ثلاثة أيام من الجلسات العلمية والورش البحثية التي ناقشت مستجدات الذكاء الاصطناعي وتطبيقاته في قطاعات الصحة والتعليم والأمن السيبراني والمدن الذكية، إلى جانب تطوير النماذج اللغوية العربية.
وشهد اليوم الختامي استعراض نتائج دراسات متخصصة تناولت موثوقية النماذج الذكية، وتحليل اللغة العربية، والتعرف على الكلام من حركة الشفاه، ورقمنة المخطوطات التاريخية، فضلًا عن استخدام الذكاء الاصطناعي في تصنيف الاستفسارات الطبية وتحليل المعلومات القانونية.
تطوير النماذج اللغوية العربية وقياس موثوقيتها
ناقشت إحدى الدراسات، التي قدمتها الباحثة ريم التميمي، أداء نماذج الذكاء الاصطناعي في فهم اللغة العربية الفصحى ولهجاتها المختلفة، من خلال تحليل نتائج 17 دراسة علمية.
وأظهرت النتائج اختلاف مستويات كفاءة النماذج في استيعاب اللهجات والمحافظة على المعاني والسياقات الثقافية، ما يؤكد الحاجة إلى تطوير أدوات تقييم أكثر شمولًا تراعي الخصائص اللغوية للعربية.
وقدمت الدراسة إطارًا بحثيًا يسهم في تطوير معايير لقياس جودة النماذج اللغوية العربية ومدى موثوقيتها.
نموذج يتعرف على الكلمات العربية من حركة الشفاه
استعرض باحثون من جامعة طيبة نموذجًا يعتمد على تقنيات التعلم العميق للتعرف على الكلمات العربية من خلال تحليل حركة الشفاه دون الحاجة إلى تسجيل صوتي.
وشملت التجربة أربع كلمات هي: «نعم، لا، آسف، شكرًا»، وحقق النموذج دقة بلغت 87.02% في التعرف عليها.
وعند إضافة فئة مخصصة للكلمات غير المعروفة، بلغت دقة النموذج 78.01%، في تجربة تستكشف إمكانات تطوير تقنيات فهم الكلام بصريًا.
الذكاء الاصطناعي في الصحة.. تصنيف 170 ألف سؤال طبي
في مجال التطبيقات الصحية، قدمت الباحثتان إيناس الرحيلي وأريج الهذلي دراسة تناولت تصنيف نحو 170 ألف سؤال طبي باللغة العربية وفق ثلاثة مستويات للخطورة.
وأظهرت النتائج تحقيق نموذج AraBERT درجة بلغت 98.29% في مقياس F1، مقارنة بـ95.59% لنموذج الشبكات العصبية الالتفافية (CNN).
وتبرز هذه النتائج الإمكانات البحثية لتطوير أدوات ذكية تساعد على تصنيف الاستفسارات الصحية وتحديد أولويات التعامل معها، مع الحاجة إلى التحقق من أدائها في البيئات الطبية الفعلية قبل استخدامها عمليًا.
تقنيات ذكية لرقمنة المخطوطات العربية
تناولت دراسة قدمتها الباحثة بشاير الصيدلاني مقارنة أداء أنظمة التعرف الآلي على النصوص العربية، من خلال تحليل 500 سطر من المخطوطات التاريخية.
وأظهرت الدراسة تفاوتًا في معدلات الخطأ بين التقنيات المستخدمة؛ إذ سجل أحد الأنظمة معدل خطأ على مستوى الحروف بلغ 27.92%، مقابل 43.66% لنظام آخر.
وفي تجربة مستقلة لاستعادة التشكيل، حقق نموذج متخصص معدل خطأ بلغ 4.06%، بما يوفر مؤشرات بحثية تساعد على اختيار الأدوات المناسبة لرقمنة المخطوطات العربية والحفاظ على محتواها.
دراسة تقيس اتساق إجابات الذكاء الاصطناعي القانونية
وفي مجال التطبيقات القانونية، استعرضت الباحثتان نورة الراجح وميادة المصري دراسة لقياس مدى اتساق إجابات ثلاثة نماذج لغوية عند التعامل مع الأسئلة القانونية باللغتين العربية والإنجليزية.
واعتمدت الدراسة على 90 سؤالًا قانونيًا تناولت نظام حماية البيانات الشخصية السعودي واللائحة الأوروبية العامة لحماية البيانات (GDPR).
وأظهرت النتائج مستوى اتساق بلغ 87% عبر 254 زوجًا من الإجابات، ما يسلط الضوء على أهمية اختبار ثبات المخرجات القانونية عند اختلاف لغة السؤال، وتطوير معايير أكثر دقة لتقييم النماذج متعددة اللغات.
جلسات علمية حضورية وعن بُعد
تضمن اليوم الثالث من المؤتمر جلسات بحثية متوازية، عُقدت حضوريًا وعن بُعد، إلى جانب ورشة عمل متخصصة.
وشملت المناقشات تطبيقات الذكاء الاصطناعي في قطاعات متعددة، مع التركيز على النتائج العلمية والتحديات التقنية المرتبطة بدقة النماذج وموثوقيتها.
وأتاح تنوع الجلسات للباحثين عرض تجاربهم وتبادل المعرفة حول أحدث الأساليب المستخدمة في تطوير أنظمة الذكاء الاصطناعي.
جامعة طيبة تكرّم المشاركين وتثمّن الشراكة الماليزية
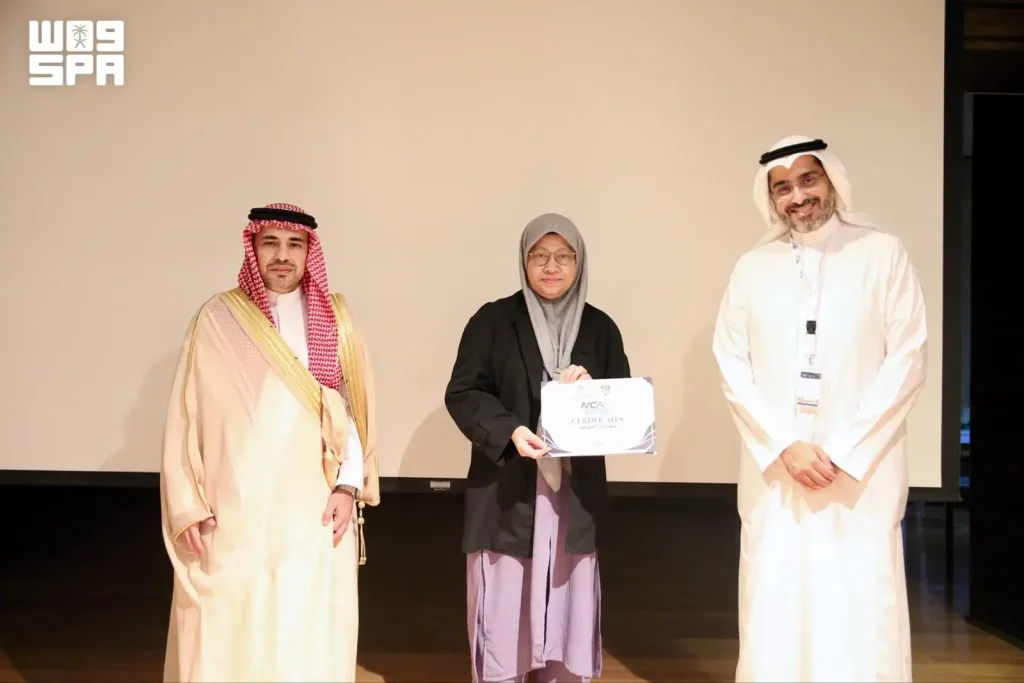
وفي ختام المؤتمر، أعربت جامعة طيبة عن تقديرها للجامعة الوطنية الماليزية نظير شراكتها العلمية في تنظيم المؤتمر، مؤكدة أهمية التعاون الأكاديمي الدولي في دعم البحث العلمي وتبادل الخبرات.
كما كرّمت الجامعة فرق العمل التي شاركت في تنظيم الجلسات والفعاليات، تقديرًا لجهودها في إنجاح النسخة السادسة من المؤتمر.
ويعكس المؤتمر تنوع مجالات البحث في الذكاء الاصطناعي، من تطوير التقنيات اللغوية إلى التطبيقات الطبية والقانونية والتراثية، بما يعزز حضور البحث العلمي في تطوير الحلول التقنية الحديثة.